20일 순천향대학교 컴퓨터소프트웨어공학과 구유겸 씨가 개발한 ‘2027학년도 수능 거대언어모델(LLM) 풀이 대시보드’에 따르면 오픈AI의 ‘GPT-6.2 아스트라(Astra)’와 구글의 ‘제미나이 4 네온(Neon)’이 450점 만점으로 공동 1위에 올랐다.
구 씨는 전날인 19일 수능 문제와 정답이 공개되자 국내외 AI 모델에 문제를 풀게 하고 결과를 대시보드에 반영했다. 국어·수학·영어·한국사·탐구 등 과목별 성적과 모델 간 점수 차이를 비교할 수 있다. 450점은 수능 필수 5개 영역(국어·수학·영어·한국사·탐구 2과목)의 원점수를 합산한 총점이다.
|
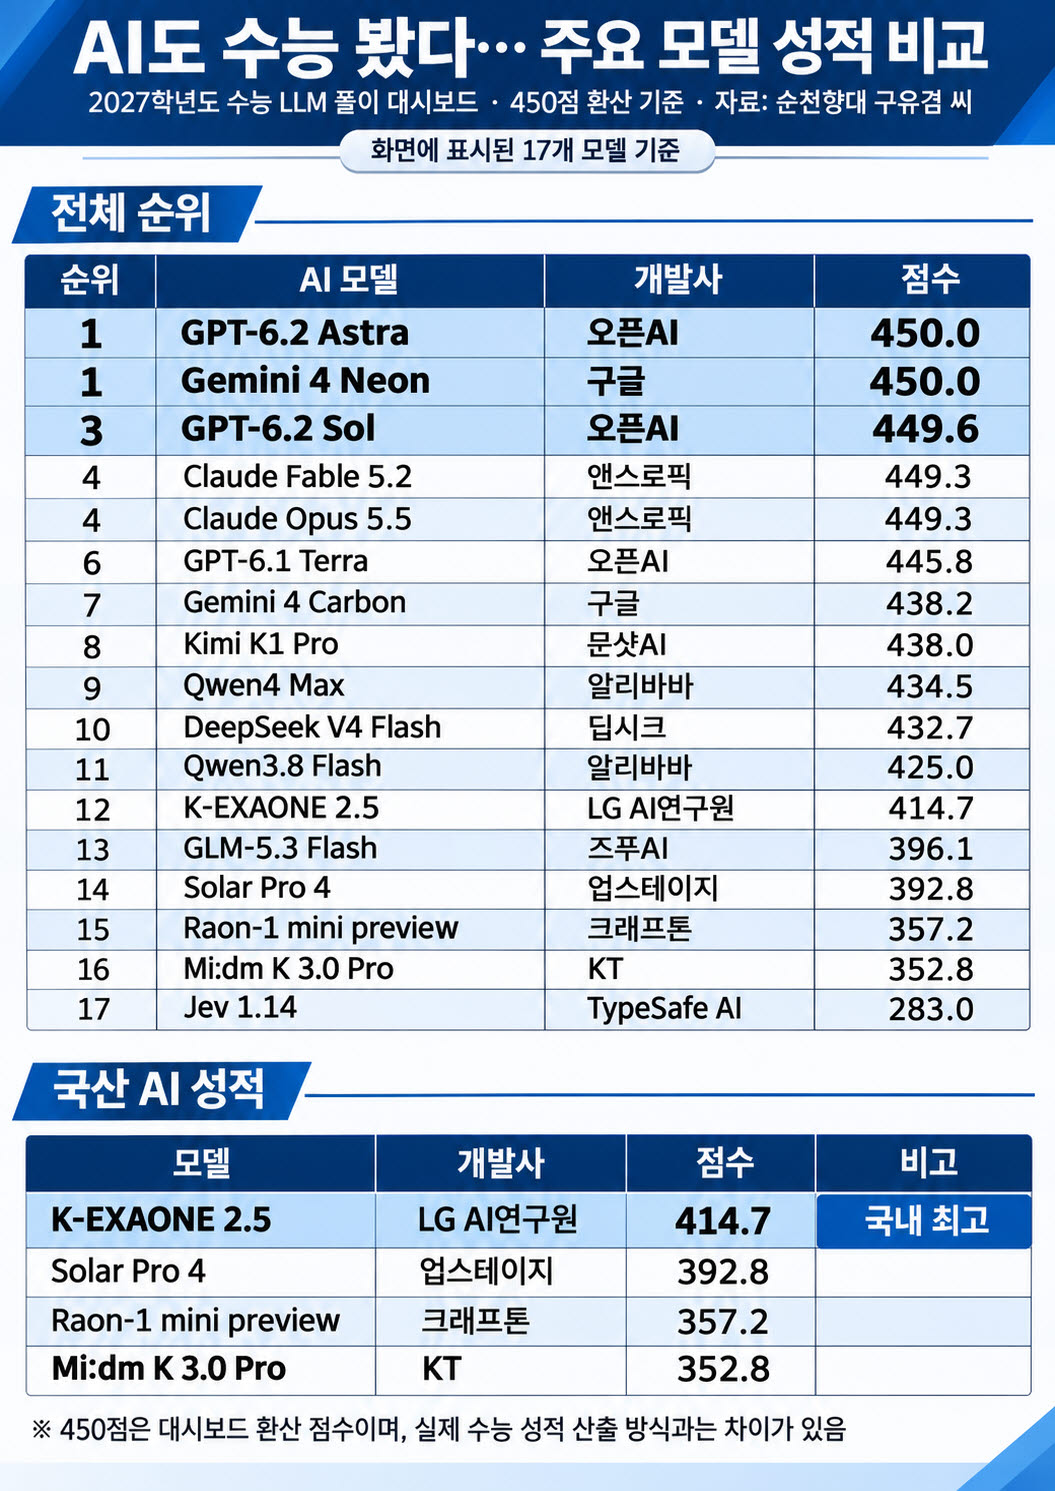
오픈AI와 구글이 공동 1위를 차지한 가운데 다른 미국 AI 모델들도 높은 성적을 거뒀다. 오픈AI의 ‘GPT-6.2 솔(Sol)’은 449.6점으로 3위, 앤스로픽의 ‘클로드 페이블 5.2’와 ‘클로드 오퍼스 5.5’는 각각 449.3점으로 공동 4위에 올랐다. 오픈AI의 ‘GPT-6.1 테라(Terra)’는 445.8점을 기록했다.
중국 AI 기업들도 상위권에 이름을 올렸다. 문샷AI의 ‘키미 K1 프로’는 438점, 알리바바의 ‘큐웬4 맥스’는 434.5점, 딥시크의 ‘딥시크 V4 플래시’는 432.7점을 받았다. 미국 모델들이 최상위권을 차지한 가운데 중국 모델들도 430점대 성적을 보였다.
한국 AI는 LG 선두…업스테이지·크래프톤·KT 뒤이어
국내 AI 모델 중에서는 LG AI연구원의 ‘K-엑사원(K-EXAONE) 2.5’가 414.7점으로 가장 높은 점수를 받았다. 테스트에 참여한 국내외 주요 모델 중 12위를 기록했다.
업스테이지의 ‘솔라 프로 4(Solar Pro 4)’는 392.8점으로 14위, 크래프톤(259960)의 ‘라온-1 미니 프리뷰(Raon-1-mini-preview)’는 357.2점으로 15위, KT(030200)의 ‘믿:음 K 3.0 프로(Mi:dm K 3.0 Pro)’는 352.8점으로 16위를 기록했다.
국내 1위인 K-엑사원 2.5도 만점 모델과는 35.3점 차이가 났다.
각 모델은 개발 목적과 규모가 다르다. 크래프톤의 라온-1 미니 프리뷰는 한국어 처리와 AI 에이전트 업무에 초점을 맞췄다. KT의 믿:음 K 3.0 프로는 한국어 추론 능력을 강화한 모델이다. 두 모델 모두 필요한 전문 신경망만 선택적으로 작동시켜 연산 부담을 줄이는 전문가 혼합(MoE) 방식을 적용했다.
구유겸 씨 “문제 공개 직후 평가…정답 암기 가능성 줄여”
이번 대시보드를 개발한 구유겸 씨는 ‘hehee9’라는 닉네임으로 활동하며 지난해부터 AI 수능 풀이 결과를 공개해 왔다. 수능이라는 익숙한 시험을 통해 일반인도 AI 모델의 문제 해결 능력을 쉽게 비교할 수 있도록 한 것이다.
이번 평가에서는 국어와 수학의 모든 선택과목을 비롯해 영어, 한국사, 과학·사회탐구 전 과목을 대상으로 했다.
구 씨는 “문제가 공개되는 것과 거의 동시에 풀이를 진행하기 때문에 모델이 이미 정답을 외웠을 가능성을 상당 부분 줄일 수 있다”고 설명했다.
평가에는 AI 모델의 응용프로그램인터페이스(API)를 직접 이용했다. 챗GPT 같은 일반 웹서비스에서는 검색이나 계산기 등 외부 도구가 문제 풀이에 영향을 줄 수 있어 이를 배제한 것이다. 구 씨는 외부 도구의 도움 없이 모델 자체의 문제 해결 능력을 비교하는 데 초점을 맞췄다.
시험 문제는 텍스트로 옮겨 제공하고, 표와 밑줄 등은 마크다운(Markdown) 형식으로 재현했다. 그림과 그래프는 고화질 이미지로 첨부했다. 이미지 입력을 지원하지 않는 모델은 그림 없이 문제를 풀도록 했다.
성적은 과목별 원점수 합계와 450점 만점 환산 점수로 확인할 수 있다. 구 씨는 “공통과목과 선택과목, 탐구영역의 반영 비중이 달라 같은 1점이라도 과목에 따라 최종 환산 점수에 미치는 영향이 다르다”고 설명했다.
무료로 이용할 수 있는 AI와 유료 구독이 필요한 모델을 구분하는 기능도 추가했다. 이용자들이 성적뿐 아니라 이용 비용에 따른 성능 차이도 비교할 수 있도록 했다.
이번 결과는 AI의 지식 이해와 문제 해결 능력이 어느 수준까지 발전했는지 보여준다. 하지만 모델마다 개발 목적이 다르고 이미지 입력 지원 여부 등 시험 조건에도 차이가 있어, 공개된 점수만으로 AI의 종합적인 경쟁력을 판단하기는 어렵다.
구 씨가 운영하는 대시보드는 ‘2027학년도 수능 LLM 풀이 대시보드’에서 확인할 수 있다.