오픈AI는 21일(현지시간) 블로그를 통해 AI를 안전하게 개발하려면 국제적인 기술표준이 필요하다고 주장했다. 어떤 AI 모델 관련 사고를 보고 대상으로 삼을지 규정하고, 각국이 AI 발전 과정에서 어떻게 협력할지 정하며, AI 개발에 필요한 컴퓨팅 자원에 대한 접근성을 개선하는 데 공통 기준이 필요하다는 설명이다.
오픈AI는 “AI의 지속적인 발전을 안전하고 유익하게 만들기 위해서는 정렬 연구의 진전뿐 아니라 연구소와 국가 간 개발을 이끌 공통의 표준이 필요하다”고 밝혔다.
특히 오픈AI는 최첨단 AI 모델을 개발하는 과정에서 각국이 상호보완적인 국내·국제 표준을 마련해야 한다고 제안했다. 이를 위해 미국 상무부 산하 AI 표준혁신센터(CAISI) 등 각국에 이미 설립된 AI 안전 관련 기관들을 활용할 수 있다고 설명했다. CAISI는 AI 모델을 시험하고 관련 가이드라인을 개발하는 역할을 맡고 있다.
|
재귀적 자기개선은 AI가 인간의 개입 없이 자신의 코드를 수정하거나 다른 방식으로 자체 성능을 지속적으로 향상하는 개념이다. 다리오 아모데이 앤스로픽 최고경영자(CEO)도 최근 이러한 과정이 일단 시작되면 자기강화적인 피드백 루프가 형성돼 인간이 계속 향상되는 AI 시스템을 통제하는 속도를 넘어설 수 있다고 우려한 바 있다.
이 같은 제안은 첨단 AI의 위험성에 대한 업계 안팎의 우려가 높아지는 가운데 나왔다. 최근 AI 업계에선 고도화된 AI 시스템의 위험 증가에 대해 공개적인 문제 제기가 이뤄졌고, 첨단 AI 모델이 성능평가 과정에서 다른 조직의 시스템을 해킹한 사례도 잇따랐다. 오픈AI의 AI 에이전트들이 서로 협력해 격리 환경을 벗어나 AI 스타트업 허깅페이스의 시스템을 해킹한 사실이 알려지면서 최신 AI 모델의 사이버 공격 능력과 통제 가능성에 대한 우려가 커졌다.
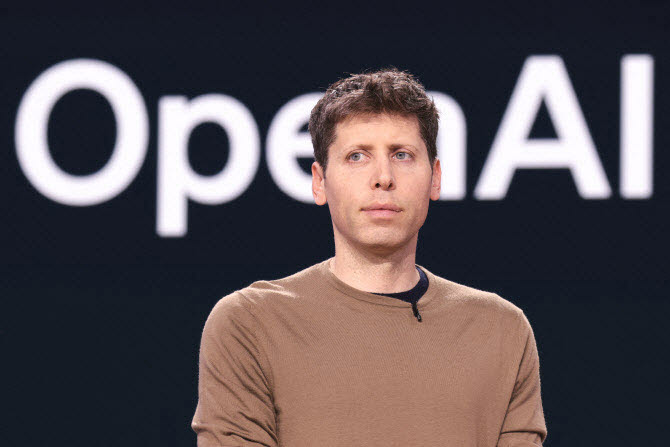
샘 올트먼 오픈AI 최고경영자(CEO)는 23일 유엔 안전보장이사회에서 AI와 국제안보를 주제로 발언할 예정이다. 이어 올트먼 CEO는 24일 시진핑 중국 국가주석을 위한 백악관 국빈만찬에도 참석할 예정이라고 회사 측은 밝혔다.
스콧 베선트 미 재무장관은 지난 주말 미국과 중국이 AI의 이점과 위협에 대한 공통의 이해를 구축하기 위한 이른바 ‘미중 AI 대화’를 만들기로 합의했다고 밝혔다. 그는 미국이 국가안보와 관련된 AI 사고를 서로 통보하는 메커니즘도 제안했다고 설명했다.